تعلم آلي تطبيقي · هندسة مجموعات البيانات
اختبار الشيفرة بالذكاء الاصطناعي
يبدأ المشروع من الأصل المفقود: مجموعة متعددة الفئات وقابلة للتتبع لعيوب شيفرة Python. ويجمع البيانات من ثلاث فئات مصادر ثم يعنونها ويزيل التكرار ويرشحها ويوازنها قبل تقييم مصنّف TF-IDF وXGBoost عبر سبع فئات نهائية.
- Python
- Corpus engineering
- TF-IDF + XGBoost
- الدور
- مطور برمجيات أكاديمي وباحث في الذكاء الاصطناعي
- السياق
- جامعة أسكودار · بحث تطبيقي في الذكاء الاصطناعي
- المنصة
- دراسة تطبيقية في تعلم الآلة
- التقنيات
- Python · TF-IDF · XGBoost
المشكلة
تستطيع أدوات التحليل الساكن الإبلاغ عن مخالفة قاعدة، لكن هذا الإخراج لا يتحول تلقائيًا إلى مجموعة بيانات مفيدة متعددة الفئات. يطرح المشروع سؤالًا مختلفًا: هل يمكن تصنيف مقتطف Python كخطأ نحوي أو وقت تشغيل أو منطقي أو مشكلة أمان أو أداء أو توافق، أو كشيفرة صحيحة؟
النموذج هو المرحلة الأخيرة فقط. فقبل إمكان التدريب، احتاج العمل إلى تصنيف واضح ومسارات جمع ذات نقاط قوة مختلفة ومنهج قابل للتتبع لتحويل المرشحات المليئة بالضوضاء إلى أمثلة معنونة.
الأشكال
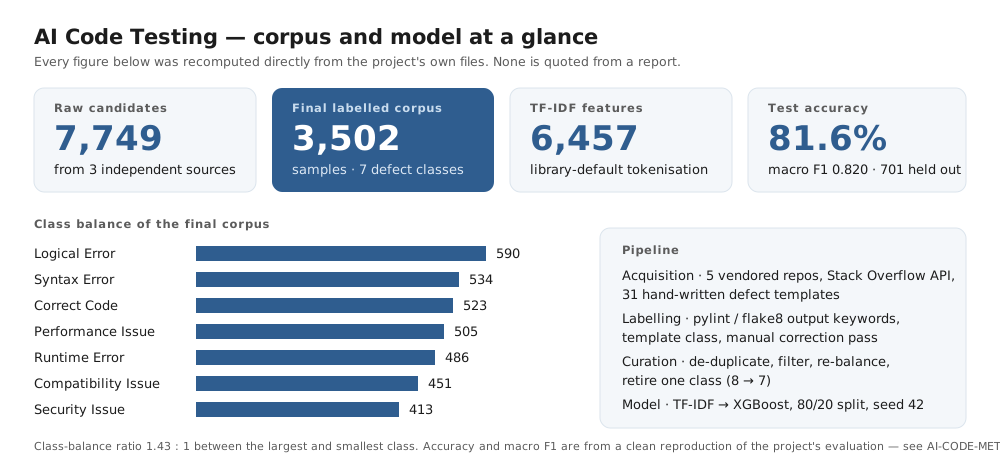
لمحة عن مجموعة البيانات ونتائج المصنّف المعاد تشغيله. 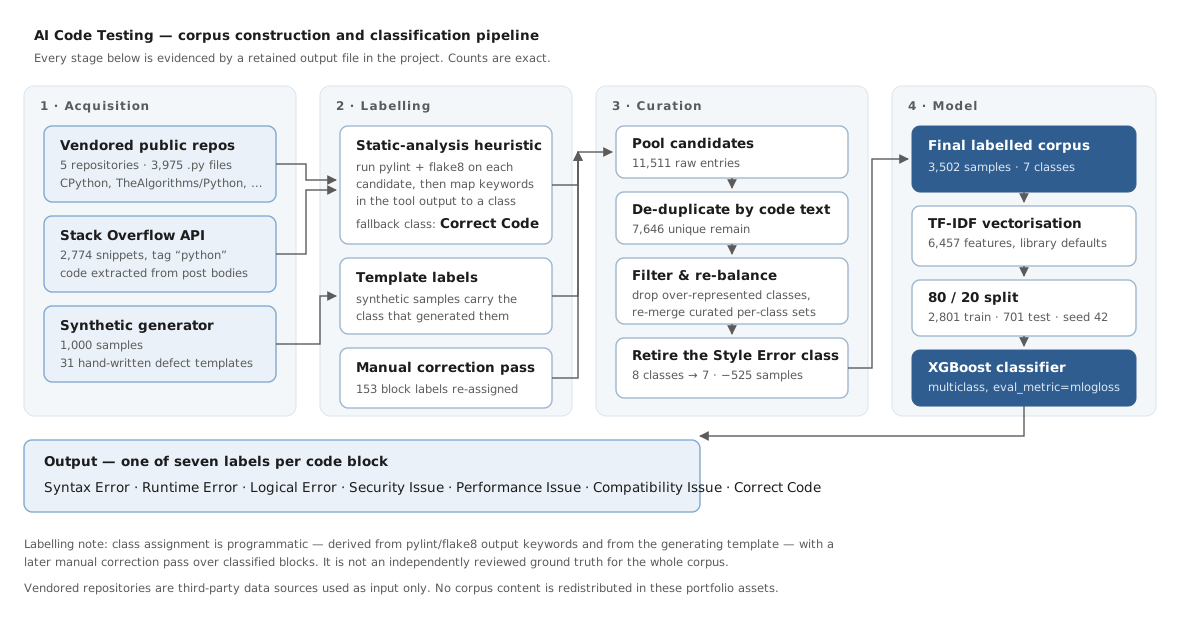
تغذي ثلاثة مسارات للمصادر الخام مسارًا واحدًا منقحًا لمصنّف من سبع فئات.
لماذا كانت البيانات هي الجزء الأصعب
لم تكن هناك مجموعة معنونة جاهزة تطابق سؤال التصنيف السباعي. وفرت ملفات المستودعات شيفرة واقعية لكنها كانت تميل بشدة إلى الشيفرة الصحيحة، وقدمت Stack Overflow كتل شيفرة قصيرة مرتبطة بنقاشات، بينما استطاع التوليد الاصطناعي استهداف أنواع العيوب الناقصة لكنه أدخل بنى متكررة. لم يكن بمقدور مصدر واحد أن يحمل المهمة وحده.
لذلك تمثل العمل الهندسي في سلسلة من قرارات البيانات: حفظ أصل كل عينة، ودمج مدخلات مختلفة، وإزالة التكرارات التامة، وربط إشارات التحليل بتصنيف موحد، ومراجعة الكتل المصنفة، وترشيح المواد غير المناسبة، ثم موازنة النتيجة دون الادعاء بأن كل تسمية حقيقة مرجعية من وضع إنسان.
ولا تزال هذه السلسلة قابلة للعد؛ تبدأ بـ7,749 مرشحًا جرى جمعها، وتصل إلى 11,511 بعد دمج مجمعات المصادر المحتفظ بها، ثم تنخفض إلى 7,646 عنصرًا فريدًا، وتنتهي عند 3,502 عينة معنونة تمثل 3,495 زوجًا فريدًا من الشيفرة والتسمية.
ثلاثة مصادر وثلاث استراتيجيات
قدّمت خمسة مستودعات Python عامة، محفوظة نسخها داخل المشروع، 3,975 ملفًا عبر فحص محلي لها. وقدمت واجهة Stack Overflow API 2,774 مرشحًا موسومًا بـPython عبر جلب النتائج على صفحات، وضبط معدل الطلبات، واستخراج كتل الشيفرة من HTML. وأضاف مولّد 1,000 مثال من 31 قالب عيب مكتوبًا يدويًا.
جمعت هذه المسارات معًا 7,749 مرشحًا خامًا. وفرت شيفرة المستودعات اتساعًا، وقدمت كتل الأسئلة والأجوبة أمثلة قصيرة متنوعة، بينما وفرت القوالب حالات مضبوطة للفئات التي لم يغطها المصدران الأولان بالتساوي.
الأشكال
مرّر أفقيًا لمعاينة الرسم البياني
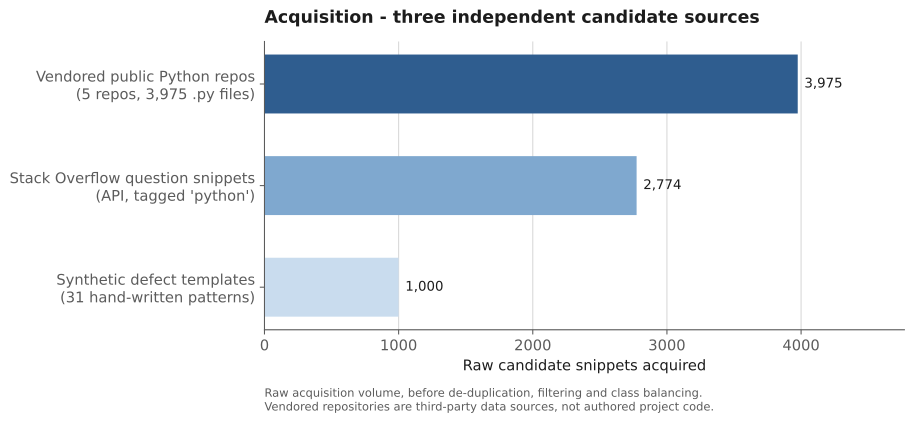
جُمعت 7,749 عينة مرشحة من المستودعات وStack Overflow والتوليد المضبوط.
العنونة وحدودها
أُسندت التسميات برمجيًا؛ فاشتُقت تسميات كتل المستودعات وStack Overflow من مخرجات pylint وflake8، بينما ورثت العينات المولدة فئة القالب الذي أنشأها. ثم أُجريت مراجعة يدوية للكتل المصنفة.
لا تمثل هذه العملية حقيقة مرجعية عنونها خبراء. كما تعمل فئة Correct Code كحاوية افتراضية عندما لا تثبت الإشارات المربوطة فئة أخرى، ولذلك فهي أوسع وأكثر تنوعًا لغويًا من فئة عيب محددة بدقة. ويساعد هذا القرار في تفسير الالتباس اللاحق مع Syntax Error بدلًا من إخفائه خلف رقم رئيسي واحد.
التنقيح غيّر مجموعة البيانات
أنتجت مجمعات المصادر المحتفظ بها 11,511 مرشحًا قبل أن تخفضها إزالة التكرار التام إلى 7,646 عنصرًا فريدًا. ثم أسفر الترشيح والموازنة اللاحقان عن 3,502 عينة نهائية. وانتقلت نسبة أكبر فئة إلى أصغر فئة من نحو 4.7:1 في الجمع الخام إلى 1.43:1 في المجموعة النهائية.
وغيّر التنقيح التصنيف أيضًا؛ فقد استمرت Style Error خلال جزء كبير من المسار ثم أُوقفت قبل التدريب النهائي، لتبقى سبع فئات. كان حذف تسمية لم يعد دليلها كافيًا قرارًا في تصميم البيانات، لا ناتجًا ثامنًا مفقودًا.
| الفئة | العينات | النسبة (%) |
|---|---|---|
| Logical Error | 590 | 16.85 |
| Syntax Error | 534 | 15.25 |
| Correct Code | 523 | 14.93 |
| Performance Issue | 505 | 14.42 |
| Runtime Error | 486 | 13.88 |
| Compatibility Issue | 451 | 12.88 |
| Security Issue | 413 | 11.79 |
| الإجمالي | 3502 | 100.00 |
الأشكال
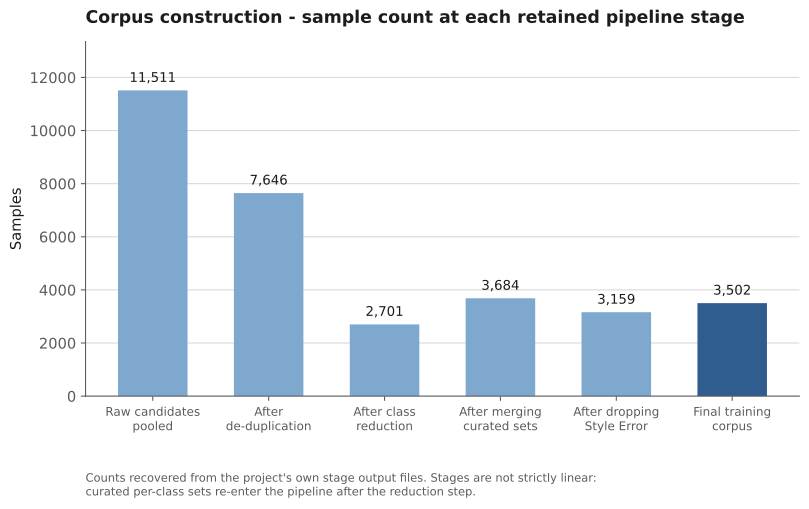
تنتقل مجمعات المصادر من 11,511 مرشحًا إلى 7,646 عنصرًا فريدًا ثم 3,502 عينة نهائية. 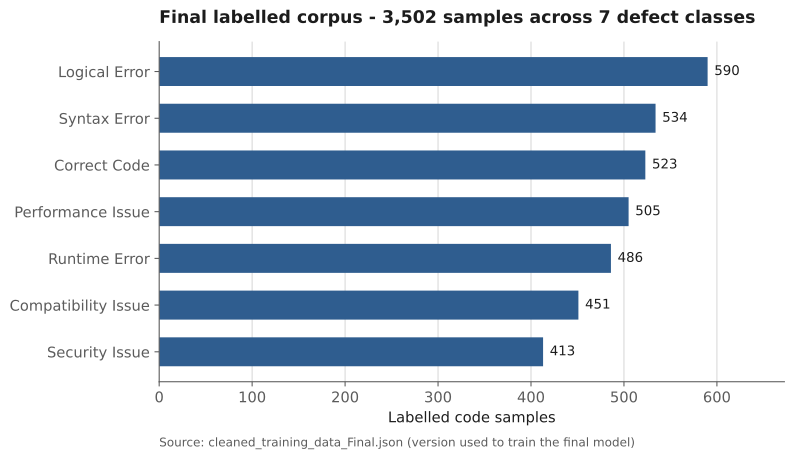
تضم المجموعة النهائية سبع فئات بنسبة 1.43:1 بين أكبر فئة وأصغرها.
الميزات والنموذج
تحول TF-IDF النص المنقح إلى 6,457 ميزة، ثم يصنفه XGBoost. ويستخدم التقييم النهائي تقسيمًا 80/20 مع random_state=42: 2,801 عينة للتدريب و701 عينة محفوظة للاختبار.
ويحدد هذا التمثيل البسيط سقف الأداء أيضًا؛ إذ يسقط نمط الرموز الافتراضي في المحول علامات الترقيم والرموز أحادية الحرف، رغم أن محارف مثل النقطتين والأقواس قد تحمل معنى نحويًا حاسمًا في Python.
النتائج وطريقة التحقق منها
حققت إعادة تشغيل نظيفة باستخدام مُرمّز تسميات موحد دقة 81.6% وmacro F1 مقداره 0.820 وweighted F1 مقداره 0.818 عبر سبع فئات على 701 عينة محفوظة. وتراوح F1 لكل فئة من 0.67 لفئتَي Correct Code وSyntax Error إلى 0.94 لفئة Performance Issue.
اشتق الدفتر الأصلي خرائط تسميات التدريب والاختبار بصورة مستقلة، ولذلك لم يكن من الآمن اعتماد تقييمه المخزن كنتيجة نهائية. وأكد تشغيل المسار نفسه بمُرمّز واحد النتيجة بفارق أقل من نقطة مئوية وجعل ربط الفئات موثوقًا.
يمثل الالتباس بين Correct Code وSyntax Error نسبة 22% من جميع الأخطاء. وتغلق هذه النتيجة الحلقة مع التسمية الافتراضية وتمثيل الرموز؛ فبعض العيوب النحوية لا تحمل الإشارات اللفظية التي يراها النموذج.
| الفئة | الإحكام | الاستدعاء | F1 | عدد عينات الاختبار |
|---|---|---|---|---|
| Compatibility Issue | 0.9200 | 0.8023 | 0.8571 | 86 |
| Correct Code | 0.6609 | 0.6786 | 0.6696 | 112 |
| Logical Error | 0.8547 | 0.8929 | 0.8734 | 112 |
| Performance Issue | 0.9596 | 0.9223 | 0.9406 | 103 |
| Runtime Error | 0.8286 | 0.7909 | 0.8093 | 110 |
| Security Issue | 0.9186 | 0.9186 | 0.9186 | 86 |
| Syntax Error | 0.6346 | 0.7174 | 0.6735 | 92 |
| المتوسط الكلي | 0.8253 | 0.8176 | 0.8203 | 701 |
| المتوسط الموزون | 0.8220 | 0.8160 | 0.8180 | 701 |
| الدقة | 0.8160 | 701 |
| الفعلية / المتوقعة | Compatibility Issue | Correct Code | Logical Error | Performance Issue | Runtime Error | Security Issue | Syntax Error |
|---|---|---|---|---|---|---|---|
| Compatibility Issue | 69 | 7 | 1 | 0 | 1 | 1 | 7 |
| Correct Code | 3 | 76 | 6 | 2 | 5 | 3 | 17 |
| Logical Error | 0 | 3 | 100 | 0 | 2 | 0 | 7 |
| Performance Issue | 0 | 5 | 0 | 95 | 1 | 0 | 2 |
| Runtime Error | 1 | 11 | 4 | 0 | 87 | 3 | 4 |
| Security Issue | 1 | 1 | 0 | 0 | 4 | 79 | 1 |
| Syntax Error | 1 | 12 | 6 | 2 | 5 | 0 | 66 |
الأشكال
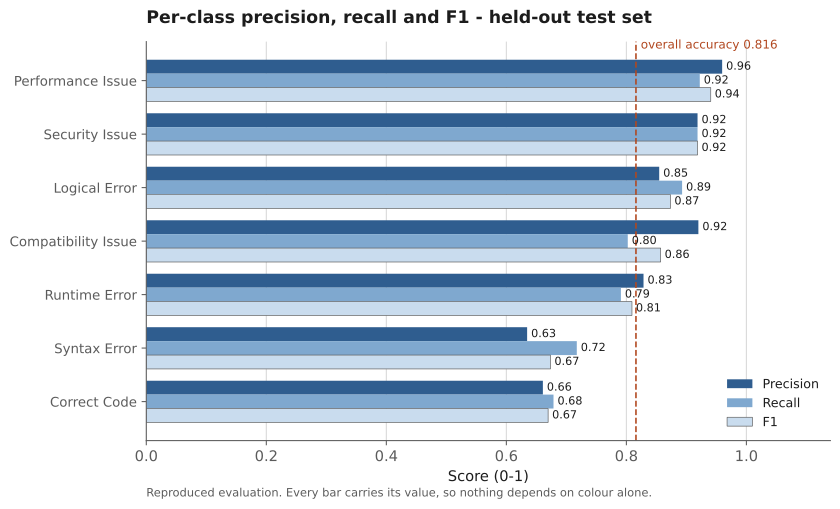
الإحكام (Precision) والاستدعاء وF1 لكل فئة على 701 عينة محفوظة للاختبار. 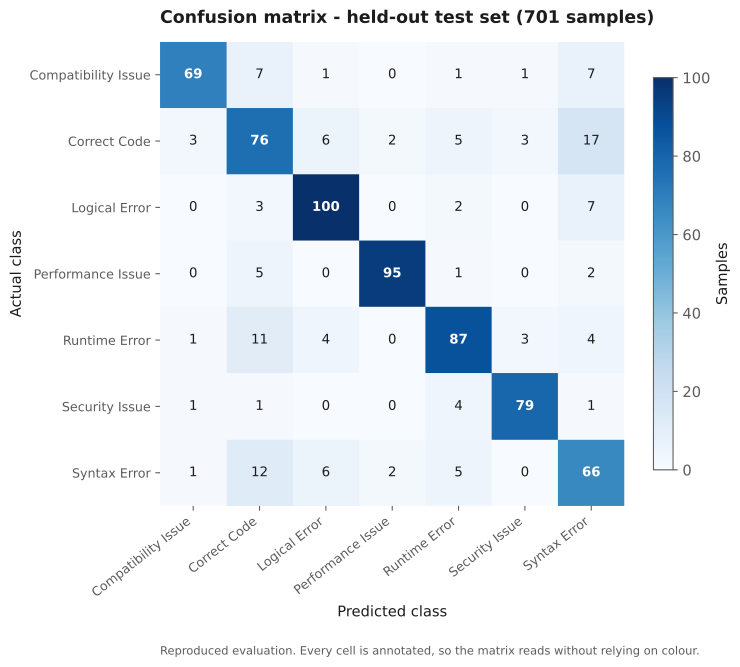
تكشف مصفوفة الالتباس مواضع نجاح التمثيل ذي الفئات السبع وإخفاقه.
ما الذي تكشفه أربعة أمثلة جديدة
استخدم فحص نوعي صغير أربعة مقتطفات جديدة كُتبت خصيصًا لهذا الفحص، ولم تُنفذ ولم تؤخذ من مجموعة البيانات. وافق تنبؤ النموذج القراءة المقصودة في اثنين من الأربعة: مثال الأمان والدالة السليمة. أما مثال النقطتين المفقودتين ومثال مخاطر وقت التشغيل فعادا إلى Correct Code.
لا يمثل ذلك مقياس دقة ثانيًا، بل اختبارًا نوعيًا محدودًا للتعميم يوضح لماذا لا يكون تكبير النموذج أول تحسين. الخطوة التالية هي تمثيل أغنى يشمل نجاح التحليل وشكل AST وأنماط أنواع الرموز، يتبعه قياس جودة التسميات وتقسيم واعٍ بالمجموعات يمنع صور القالب الواحد من الظهور في التدريب والاختبار معًا.